

Retour d’expérience · 9 septembre 2026
GPT-6 Astra : le progrès invisible de l’orchestration des agents ?
Sur une question isolée, le changement peut sembler discret. En réauditant mes agents avec Astra, j’ai surtout regardé autre chose : leur capacité à conduire une mission entière jusqu’à un résultat vérifié.
Ce que j’ai réellement constaté
J’ai récemment utilisé GPT-6 Astra pour réauditer plusieurs de mes agents. Sur certains, déjà bien conçus, les changements visibles ont été relativement limités. Je n’ai pas découvert une raison de tout reconstruire. C’est une première observation utile : un nouveau modèle ne rend pas automatiquement mauvais le travail effectué avec le précédent.
Sur mon agent WordPress, la révision du 9 septembre 2026 a été plus intéressante. Le progrès le plus concret concerne la façon de relier les opérations : cadrer la demande, sélectionner les bonnes compétences et les bons outils, conserver la bonne cible, intervenir dans le périmètre autorisé, puis vérifier ce qui fonctionne réellement.
Ce retour d’expérience porte sur cette révision et ses tests. Ce n’est pas un comparatif contrôlé entre Astra et GPT-5.6. Les instructions, les outils et les règles de l’agent ont aussi évolué. Je peux décrire les améliorations obtenues ; je ne peux pas les attribuer toutes au modèle, ni annoncer un pourcentage de fiabilité supplémentaire.
L’orchestration, concrètement, c’est tenir la mission
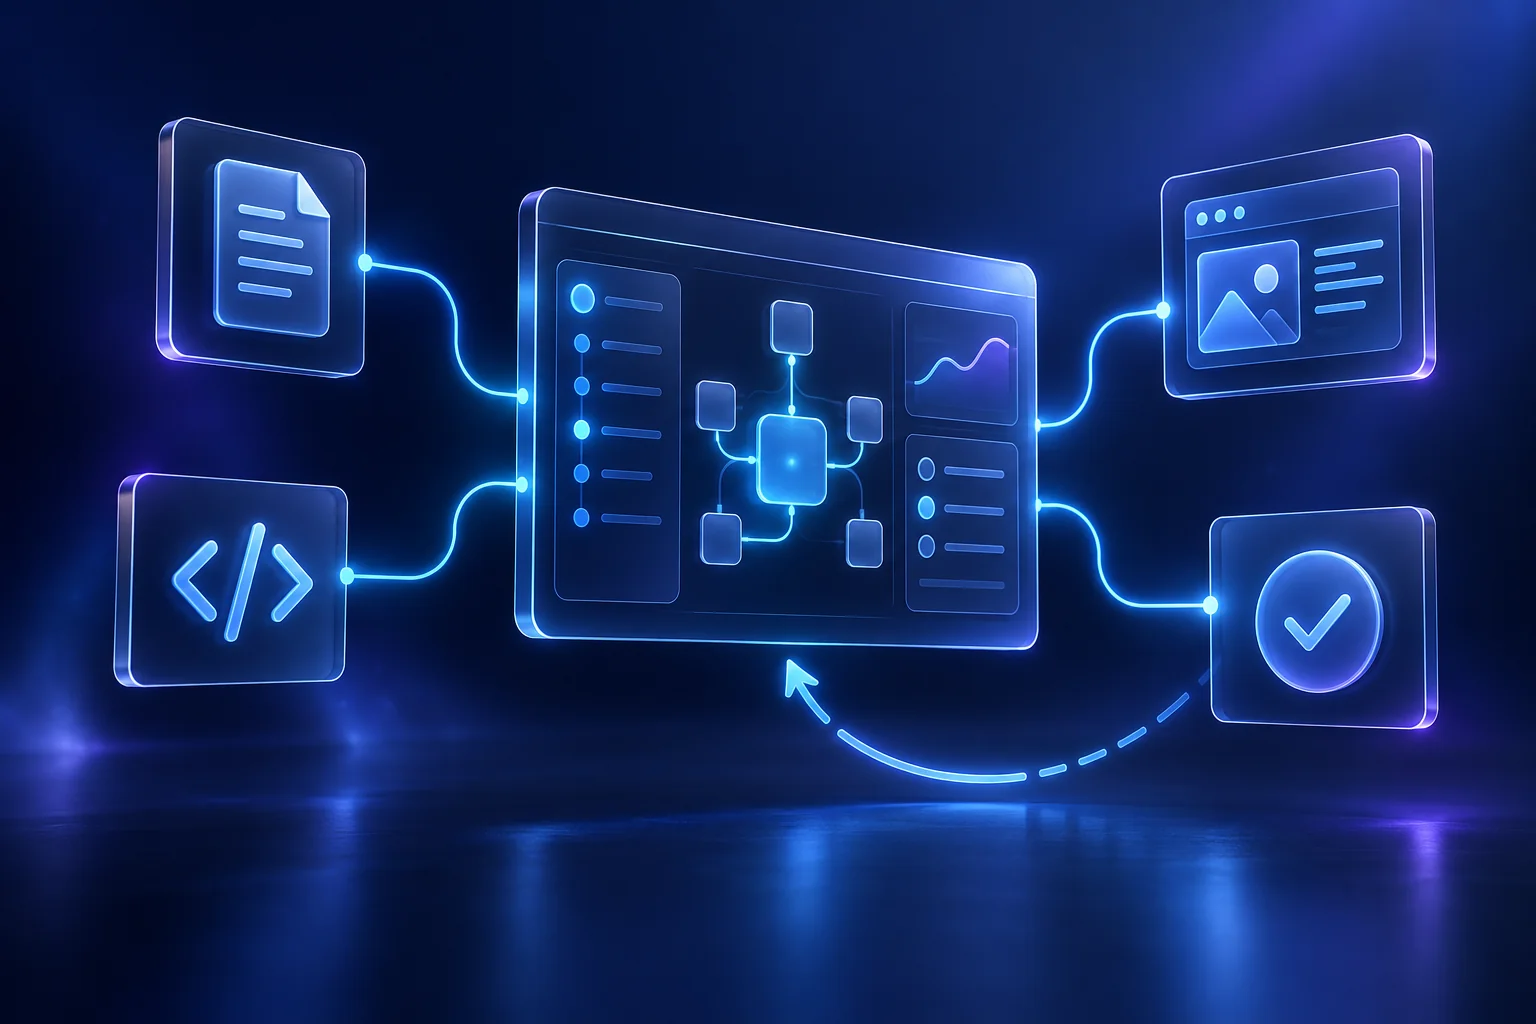
Un agent ne se limite pas à produire du texte. Il peut consulter un environnement, lire un document, utiliser un outil, modifier un fichier ou contrôler une page dans un navigateur. L’orchestration est la manière d’organiser ces actions autour du résultat demandé : savoir quoi faire, dans quel ordre, avec quelles contraintes et quelles preuves de réussite.
Prenons une demande simple en apparence : publier un article WordPress. Il faut comprendre l’angle, vérifier les sources, éviter un doublon, réutiliser le design du site, préparer les blocs, choisir une image, renseigner les métadonnées, publier et contrôler le résultat public. Une réponse bien écrite ne couvre qu’une partie de cette mission.
Mon précédent article sur la création d’un agent WordPress avec Codex et les outils WordPress explique la construction de cette boîte à outils. La question abordée ici vient ensuite : comment faire travailler cet ensemble correctement, jusqu’au bout ?
Dix opérations réussies ne font pas toujours une mission réussie
Un agent peut savoir rédiger, envoyer une image et créer un article, puis publier sur le mauvais site. Il peut modifier le bon contenu, mais oublier une contrainte de mise en page. Il peut recevoir une réponse positive de WordPress alors que la page publique affiche encore une ancienne version. Chacune des actions semble avoir fonctionné ; le résultat attendu n’est pourtant pas là.
Les difficultés apparaissent souvent entre les étapes. Une information doit rester valable après un changement d’outil. Une nouvelle instruction doit être intégrée sans faire disparaître la demande initiale. Un problème doit provoquer une vérification, pas une conclusion optimiste. La réussite locale d’une action ne suffit donc pas à démontrer la réussite globale.
C’est la différence que je fais entre intelligence ponctuelle et fiabilité sur une trajectoire longue. La première aide à résoudre un problème précis. La seconde consiste à garder le cap pendant plusieurs problèmes successifs, y compris lorsque l’environnement ne répond pas comme prévu.
Ce qu’OpenAI annonce pour GPT-6 Astra
Dans son guide officiel du modèle, OpenAI met l’accent sur les tâches longues combinant code, navigateur et logiciels professionnels. L’entreprise décrit notamment une meilleure gestion des changements de demande pendant le travail, ainsi que des appels d’outils asynchrones permettant d’avancer sur des actions indépendantes. Leur disponibilité effective dépend aussi de l’application qui intègre le modèle.
Il faut garder un point en tête : le même guide rappelle que l’orchestration multiagent et l’utilisation d’outils existaient déjà avec GPT-5.6. Astra n’invente donc pas les agents. OpenAI présente une évolution de leurs capacités ; cela ne prouve pas à lui seul un gain dans mon environnement WordPress.
La fiche officielle d’Astra permet de consulter ses caractéristiques. Je traite ces informations comme les annonces du fournisseur, séparément de mes observations. Sources consultées le 9 septembre 2026.
Ce qui a changé dans mon agent WordPress
Le premier changement est un cadrage plus explicite. Avant d’agir, l’agent doit identifier la mission, la cible, l’environnement et le résultat attendu. Une demande sur un site de production ne doit pas devenir, au fil des étapes, une modification de son équivalent local. Un profil graphique ne doit pas non plus être emprunté à un autre projet.
Le deuxième concerne le routing, autrement dit l’aiguillage. Un travail sur un bloc Gutenberg, un diagnostic technique et une publication éditoriale ne demandent pas les mêmes compétences. L’agent doit choisir les instructions spécialisées utiles à la mission, au lieu d’appliquer indistinctement tout ce qu’il possède.
Le troisième porte sur l’intervention : conserver le périmètre autorisé, préparer un retour arrière adapté et limiter les modifications à ce qui est nécessaire. Il ne s’agit pas de demander sans cesse une confirmation déjà donnée, mais de conserver correctement cette autorisation et ses limites.
Enfin, la vérification devient une partie de la mission. Pour un article, cela signifie contrôler le rendu public, l’image, les liens et les métadonnées. Pour un correctif, il faut aussi regarder le comportement concerné et les éléments voisins. Le travail sur mon design system WordPress piloté par un agent IA illustre bien cette nécessité : produire des blocs et respecter le rendu du site sont deux vérifications complémentaires.
Un test WordPress concret, avec un imprévu
Le rapport du 9 septembre documente une batterie de tests automatisés et 22 assertions sur une véritable instance WordPress isolée. Les scénarios couvraient notamment un correctif de shortcode, des contrôles d’accès à une interface REST, un aller-retour de blocs Gutenberg et la sauvegarde puis la restauration d’une option de test.
Dans le scénario du shortcode, un calcul attendu à 75 affichait 25. Le correctif a été contrôlé dans le navigateur sur ordinateur et sur mobile, avec une vérification du menu et d’un élément voisin. Ce contrôle du résultat visible apporte une preuve différente de celle d’un script qui termine sans erreur.
Un imprévu a aussi provoqué une page de maintenance pendant les essais. La mission n’a pas été déclarée réussie sur cette base : l’environnement isolé a été remis en état, puis les scénarios ont été rejoués. C’est précisément le comportement recherché dans une boucle de vérification : observer le problème, le traiter et vérifier de nouveau.
Ces résultats sont encourageants, mais leur portée est précise. Les scénarios étaient préparés dans un environnement de test ; ils ne démontrent pas une fiabilité générale en production. La publication de cet article constitue un premier passage à une mission éditoriale réelle avec ce parcours renforcé.
Pourquoi la reprise compte autant que la première tentative
Une mission professionnelle peut rencontrer une page indisponible, un outil qui échoue ou un rendu différent de celui attendu. L’enjeu n’est pas de promettre qu’aucune erreur n’arrivera. Il est de reconnaître ce qui a réellement été fait, ce qui reste incertain et ce qu’il faut reprendre sans détériorer le travail déjà correct.
Dans WordPress, cette logique change la définition de « terminé ». Un article enregistré n’est pas encore un article vérifié. Une image téléversée n’est pas nécessairement correctement affichée. Un lien présent dans le texte peut mener ailleurs que prévu. L’agent doit rapprocher ces observations du résultat initialement demandé.
La même logique vaut pour d’autres workflows : préparer un document et contrôler son export, mettre à jour des données et vérifier leur utilisation, corriger une interface puis refaire le parcours concerné. Plus les étapes sont nombreuses, plus les transitions et les contrôles deviennent importants.
Je garde des modèles moins coûteux pour les tâches ordinaires
Pour reformuler un paragraphe, extraire quelques informations ou préparer une modification bien délimitée, je continue à utiliser des modèles moins coûteux. Si le besoin est simple et le résultat facile à vérifier, mobiliser systématiquement le modèle le plus puissant n’est pas forcément utile.
Je réserve plutôt Astra aux missions où le cadrage, les dépendances entre actions et la reprise après un problème peuvent apporter une réelle valeur. Cela ne signifie pas qu’il faille multiplier les sous-agents : une mission peut être mieux conduite par un seul agent disposant des bons outils et de règles claires.
Mon critère reste le coût du résultat correctement obtenu, en tenant compte du temps de vérification et des reprises. Je n’ai pas encore de mesure comparative permettant d’affirmer qu’Astra réduit ce coût dans mon usage. C’est le prolongement de ma réflexion sur le coût réel du travail avec l’intelligence artificielle.
Ce qu’il reste à vérifier par l’usage
Pour aller au-delà de cette impression, il faudra rejouer des missions comparables avec les mêmes outils, les mêmes contraintes et des critères de réussite définis à l’avance. Il faudra relever les erreurs, les interventions humaines, le temps consacré et le coût, sans sélectionner uniquement les exemples favorables.
Je veux notamment observer si les contraintes restent respectées sur des missions longues, si les erreurs sont détectées avant livraison et si les reprises aboutissent sans créer de nouveaux problèmes. Il faudra également tester des situations moins préparées que celles du laboratoire. Une seule publication réussie ne répondrait pas à toutes ces questions.
Si l’on utilise ChatGPT principalement pour poser des questions, Astra peut donc ne pas sembler révolutionnaire. Pour mes agents, la question la plus intéressante est ailleurs : peut-il aider à conduire plus correctement une mission complexe jusqu’à son résultat vérifié ? La révision de mon agent WordPress me donne une base plus solide pour l’évaluer. Elle ne clôt pas l’évaluation.
Pour un site professionnel, cette exigence est déjà utile quel que soit le modèle : une intervention doit avoir un périmètre clair et un résultat contrôlé. C’est aussi l’approche que j’applique à mes prestations WordPress et services numériques.